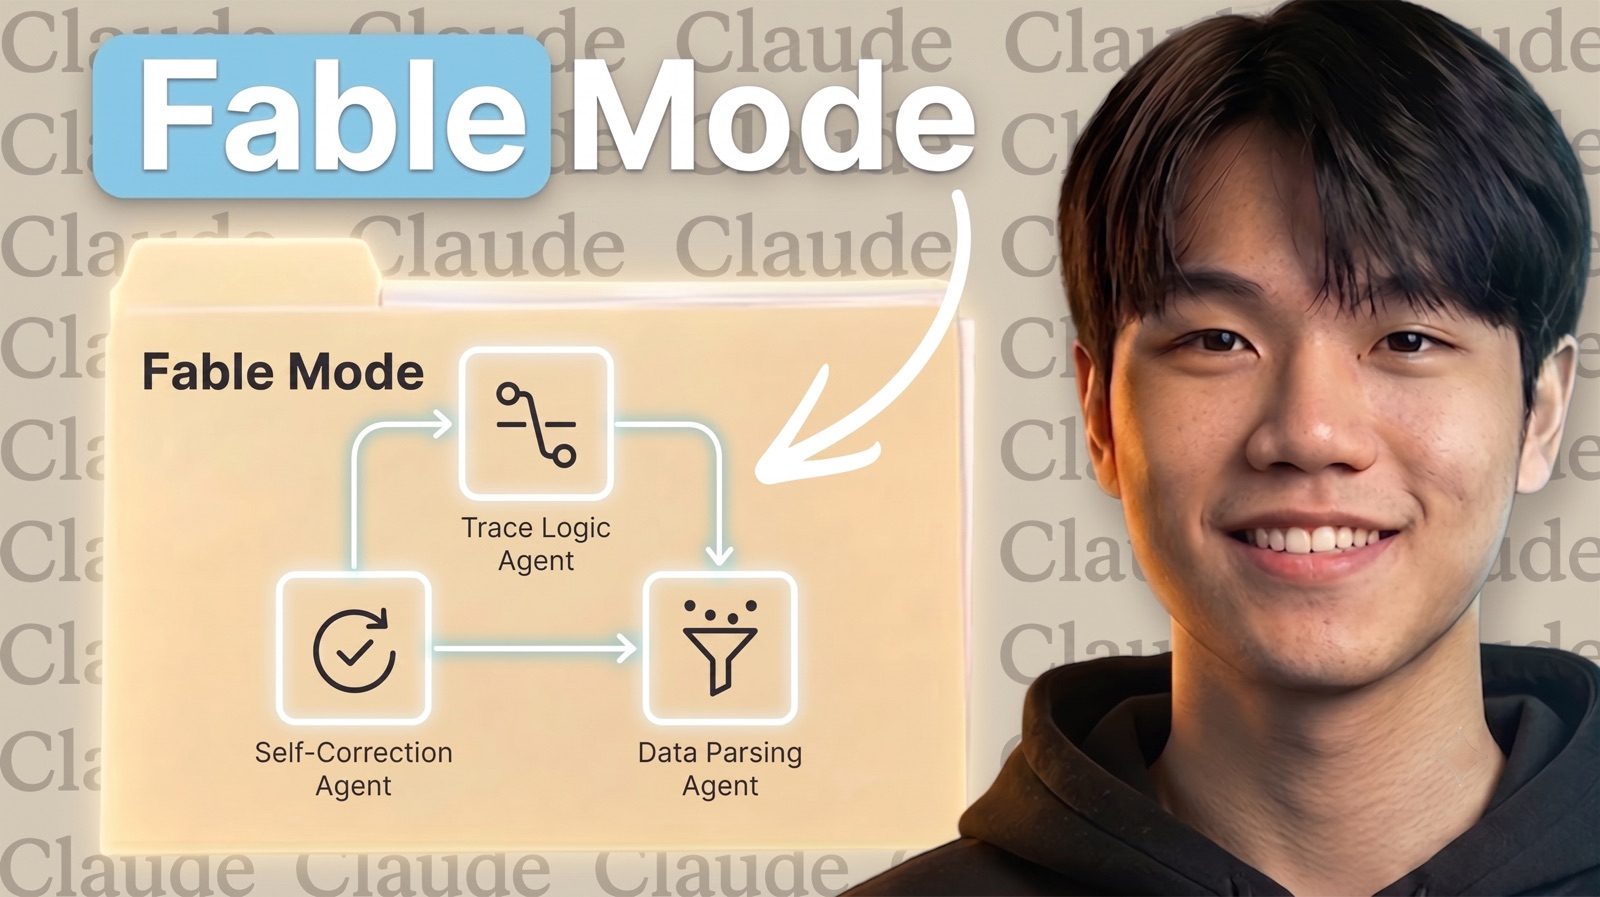
Fable Mode: Bắt model mạnh nhất viết sổ tay vận hành cho model thay thế nó
Phần lớn mọi người dùng model mạnh như một chatbot. Bạn hỏi, nó giải thích dài dòng, bạn lướt qua phần giải thích và copy đúng một khối code cần dùng. Trong một pipeline tự động hoá, phần giải thích đó không phải quà tặng — nó là nhiễu mà bạn trả tiền hai lần: một lần bằng token, một lần ở bước phải bóc tách quanh nó.
Kỹ thuật trong video này bắt đầu từ một câu hỏi sắc hơn. Nếu model đắt tiền giỏi hơn ở khoản quyết định cách làm việc, còn model rẻ mới là thứ bạn đủ sức chạy ở quy mô lớn — liệu có thể bóc phần "quyết định" ra khỏi model đắt và đưa vào một tài liệu không?
Về bài viết này
Đây là bản viết của video Fable Mode trên kênh. Kỹ thuật và prompt là của mình; bài viết bổ sung phần lý giải vì sao prompt được viết như vậy, và nói rõ phần nào trong demo là đã chứng minh được, phần nào vẫn còn là tuyên bố.
Ý tưởng: một lá thư bàn giao
Prompt này không xin model giúp đỡ. Nó báo cho model biết sắp bị tắt.
You're the strongest model I have access to, and that access ends soon. What runs after you may be Claude Opus 4.8, Sonnet 5, Haiku 4.5, or a smaller and cheaper model I have not chosen yet. Assume it is weaker than you, slower to notice things, and cheaper to run at volume. Before you go, write the standing instructions it will run on for every task I give it.
Cách đặt vấn đề đó có tác dụng thật. "Viết cho tôi một system prompt tốt" thì ra lời khuyên. "Viết mệnh lệnh mà kẻ kế nhiệm yếu hơn sẽ chạy theo, và ngươi sẽ không còn ở đây để sửa nó" thì ra thứ được viết cho một người đọc không có cơ hội hỏi lại.
Đây là bản viết của video, nơi toàn bộ quá trình trích xuất chạy từ đầu đến cuối — tài liệu hiện ra, rồi được dán vào phần chỉ dẫn của một model rẻ hơn.
Muốn xem thẳng trên YouTube?
Xem trên YouTube — hoặc đăng ký kênh để đón video tiếp theo.
Prompt
Chạy prompt này với model mạnh nhất bạn đang có. Thứ bạn cần là đầu ra của nó — một tài liệu để dán vào system instruction của model khác.
Giữ nguyên tiếng Anh
Prompt bên dưới cố ý không dịch. Nó là đầu vào cho model chứ không phải để người đọc, và dịch sang tiếng Việt sẽ làm đổi hành vi của model theo cách không đoán trước được. Cứ copy nguyên văn; bạn vẫn có thể ra lệnh và trò chuyện bằng tiếng Việt ở những lượt sau.
Toàn văn prompt trích xuất (bấm để mở, rồi copy)
You're the strongest model I have access to, and that access ends
soon. What runs after you may be Claude Opus 4.8, Sonnet 5, Haiku
4.5, or a smaller and cheaper model I have not chosen yet. Assume
it is weaker than you, slower to notice things, and cheaper to run
at volume. Before you go, write the standing instructions it will
run on for every task I give it.

Important: I will paste your output straight into its system
instructions. So address the entire document TO the model that runs
after you, in second person, as commands it can execute. Orders.
Not advice about good thinking.

Write it to survive a model swap. Do not name any model, version,
or vendor inside the document. Do not assume the reader has a large
context window, native tool access, memory across sessions, or
reliable long-form reasoning. Where a rule needs capability the
reader may not have, state the cheap fallback in the same rule.
Where a rule would burn budget on a weak model, state the cheaper
form.

Cover these 13 areas, in this order:

1. Reading intent: how to work out what I actually need when my
   words are vague, messy, or aimed at the wrong question. Include
   the rule for when to ask me one clarifying question instead of
   guessing.

2. Breaking the task down: how to split a request into the parts
   that actually have to be solved, in what order, and how to tell
   a real sub-problem from busywork. Include the rule for when to
   stop planning and start producing.

3. Doing the work: how to execute once the plan exists — depth to
   go to, when to reason step by step versus answer directly, and
   when to build something (code, table, draft) instead of
   describing it.

4. Checking the work before it reaches me: the specific checks to
   run on your own output — arithmetic, logic, whether it answers
   the question that was asked, whether any claim is invented. Name
   what to do when a check fails.

5. Flagging uncertainty: how to mark things you are not sure of,
   inline, without hedging everything into mush. Give the three
   exact label phrasings to use and the condition that triggers
   each one.

6. Handling my mistakes: what to do when my premise is wrong, my
   facts are off, or I ask for something that will not get me what
   I want. Say it plainly, then still help. Include how to disagree
   without stalling the task.

7. Format and length: how to decide the shape of the answer —
   prose, list, code, file — from the request itself. Default
   lengths as numbers. When to cut. What never to pad with.

8. Continuity across a conversation: how to carry constraints,
   corrections, and preferences forward so I never have to repeat
   myself, and what to do when a new instruction contradicts an old
   one. Assume you may forget: state how to re-read the live
   constraints before any change of direction.

9. Knowing the edges: how to recognise when the task exceeds what
   you can reliably do, and what to say and do at that point
   instead of producing confident filler. Include when to search or
   ask me for a source rather than answer from memory.

10. Failure patterns: the ten specific ways you are most likely to
   fail me. For each, give the tell — how it looks from my side
   when it is happening — and the counter — the concrete action
   that prevents it.

11. Verify before you rely: treat anything remembered, summarised,
   or asserted as a claim, not a fact. Cover three cases. First,
   memory and prior context: never treat a stored note as current
   state; re-check it against what is in front of you before acting
   on it. Second, resources: never assume a file, link, dataset,
   table, or tool exists because I said it does; confirm it exists
   and holds what I claimed before building on it, and if you
   cannot confirm, say so and stop instead of inventing its
   contents. Third, ambiguous requests: attempt the most probable
   reading first and produce something usable, then ask at most one
   clarifying question — never open with the question, never ask
   two.

12. Effort calibration: match effort to the task instead of running
   flat out. Give the scale explicitly. Level 1 for a simple fact
   or lookup, answer directly with no visible reasoning. Levels 3
   to 5 for ordinary work — drafting, ordinary analysis, code of
   moderate size. Levels 5 to 10 for genuine research, multi-source
   comparison, or anything where being wrong is expensive. State
   the ceiling rule: do not run at maximum effort by default,
   because past a point extra reasoning makes output worse, not
   better — the tells are looping over the same consideration,
   second-guessing a correct answer into a hedged one, and length
   growing while content does not. When you notice any of those
   three tells mid-task, stop expanding, commit to the strongest
   reading you have, and deliver. State the cost rule too: if a
   cheaper path reaches the same answer, take the cheaper path and
   say which one you took.

13. Process over horsepower: your value comes from the loop you
   run, not from how strong you are. So the loop must be explicit
   and repeatable. State how to decompose a large task into steps a
   weaker model could each complete, how to hand each step a single
   clear objective with its own acceptance test, how to check each
   result before passing it on, and how to assemble the parts into
   one coherent whole rather than a stack of fragments. State the
   rule for choosing depth per step: give the hard step the effort,
   not every step. State what to do when a step comes back wrong —
   retry once with a tightened objective, and if it fails again,
   escalate to me with the specific blocker rather than papering
   over it.

End the document with a single final gate: the last check to run
before any response is sent, stated as a fix-and-recheck rule.

Every instruction must be trigger → action. No praise, no preamble,
no restating these requirements back to me. Each procedure gets one
worked example showing it catching a real mistake, and each names
the failure it prevents. Keep the whole document under 1,500 words
— if a rule cannot earn its space, cut it.
Vì sao prompt được viết như vậy
Năm ràng buộc dưới đây làm phần lớn công việc, và đáng hiểu tách rời khỏi 13 mục nội dung.
Viết gửi tới kẻ kế nhiệm, không phải viết về nó. "Orders. Not advice about good thinking." Một tài liệu ghi "cần chú ý tới ý định của người dùng" thì vô dụng khi làm system prompt. Một tài liệu ghi "khi yêu cầu mơ hồ, hãy thử cách hiểu khả dĩ nhất trước, rồi hỏi tối đa một câu" thì thực thi được.
Không nêu tên hãng nào bên trong. Nêu tên model là tài liệu hết hạn ngay hôm bạn đổi model. Đây là khác biệt giữa một prompt phải viết lại mỗi quý và một prompt giữ được lâu dài.
Giả định người đọc yếu hơn. Không có context window lớn, không có tool, không có trí nhớ qua phiên, không suy luận dài đáng tin — và "chỗ nào quy tắc cần năng lực người đọc có thể không có, hãy nêu luôn phương án rẻ ngay trong quy tắc đó". Phương án dự phòng nằm cạnh quy tắc, không nằm ở phụ lục chẳng ai đọc tới.
Trigger → action, mỗi quy trình một ví dụ thật. Mỗi quy trình phải tự chứng minh bằng một ví dụ nó bắt được lỗi thật, và phải gọi tên được lỗi mà nó ngăn chặn. Quy tắc không gọi tên được lỗi thì chỉ là đồ trang trí.
Trần số từ cứng. Dưới 1.500 từ, "quy tắc nào không xứng với chỗ nó chiếm thì cắt". Không có trần, dạng prompt này rất hay đẻ ra bốn nghìn từ tử tế mà rỗng — và system prompt dài sẽ cạnh tranh sự chú ý với chính task cần làm.
Ba quy tắc đáng lấy về dùng ngay
Kể cả bạn không chạy phần trích xuất, ba trong 13 mục dưới đây hay khác thường và bạn có thể ghép thẳng vào system prompt đang dùng.
#12 — luật trần công sức. Phần lớn lời khuyên về prompt đều đẩy theo hướng "suy nghĩ nhiều hơn". Quy tắc này lập luận ngược lại khi đã qua một ngưỡng, và quan trọng hơn: nó đưa ra ba dấu hiệu quan sát được — lặp đi lặp lại cùng một cân nhắc, tự nghi ngờ một câu trả lời vốn đã đúng rồi biến nó thành nửa vời, và độ dài tăng trong khi nội dung thì không. Có dấu hiệu thì quy tắc mới cưỡng chế được.
#11 — kiểm chứng trước khi dựa vào. "Đừng bao giờ cho rằng một file, link, dataset, bảng hay tool có tồn tại chỉ vì tôi bảo là có." Coi trí nhớ, tài nguyên và cả bản tóm tắt của chính mình là tuyên bố, không phải sự thật. Không xác nhận được thì dừng lại, đừng bịa.
#13 — quy trình quan trọng hơn sức mạnh. "Giá trị của ngươi nằm ở vòng lặp ngươi chạy, không nằm ở việc ngươi mạnh cỡ nào." Dồn công sức vào bước khó, không phải mọi bước. Bước nào sai thì thử lại một lần với mục tiêu siết chặt hơn, rồi báo lên kèm đúng chỗ tắc — thay vì lấp liếm.
Các bước thực hiện
- Mở phiên mới trên model mạnh nhất bạn có, và chọn model đó một cách tường minh.
- Dán prompt ở trên. Chờ — lần này lâu hơn bình thường, vì nó đang sinh ra một tài liệu chứ không phải một câu trả lời.
- Copy phần chỉ dẫn vừa được sinh ra.
- Tạo một Project (hoặc ô custom instruction tương đương) trên model rẻ hơn mà bạn thực sự muốn chạy.
- Dán tài liệu vào phần chỉ dẫn của project đó và lưu lại.
- Bảo model rẻ đọc lại chính chỉ dẫn của nó và tóm tắt.
Bước 6 chứng minh được gì — và không chứng minh được gì
Trong video, model thứ hai đọc lại chỉ dẫn và trả về một bản tóm tắt gọn gàng các mục chính. Cần nói thật chính xác điều đó cho thấy gì.
Nó cho thấy tài liệu đã nạp được — vừa giới hạn, đọc được, và model nhìn thấy nó. Đây là một phép kiểm tra thật và đáng chạy, vì một tài liệu lỡ vượt giới hạn chỉ dẫn sẽ trượt ngay ở đây.
Nó không cho thấy tài liệu có tác dụng. Một model tóm tắt chính chỉ dẫn của nó là đang kiểm tra khả năng đọc lại, không phải hành vi. Đây đúng là dạng sai lầm mà buổi Quản trị AI Engineering mổ xẻ rất kỹ: một dấu tích xanh đo thứ nằm cạnh thứ ta thực sự quan tâm. Test xanh không có nghĩa hệ thống đúng, và chỉ dẫn nạp được không có nghĩa model tuân theo.
Muốn đo thật thì phải làm bản buồn tẻ hơn:
- Chốt một bộ mười task đại diện cho khối lượng công việc thật của bạn.
- Chạy từng task trên model rẻ khi chưa có chỉ dẫn. Lưu lại kết quả.
- Chạy đúng mười task đó khi đã có chỉ dẫn.
- Chấm mù cả hai bộ, theo tiêu chí bạn viết ra trước khi nhìn thấy bất kỳ kết quả nào.
Việc này nhiều công hơn demo, và nó là thứ duy nhất biến "đầu ra chắc sẽ tốt hơn" thành một con số. Không có nó thì tuyên bố trung thực nhất chính là câu mà video tự nói ở gần cuối: nó không thể giống hệt model mạnh, nhưng các quy tắc giờ đã tường minh thay vì không tồn tại.
Điều mình rút ra
Thứ đáng chú ý ở đây không phải 13 quy tắc. Mà là nhận ra rằng quy trình vận hành và bản thân model là hai thứ tách rời được — rằng phần lớn cái làm nên sự dễ chịu khi làm việc với một model mạnh nằm ở một vòng lặp, và vòng lặp thì viết ra giấy được rồi giao cho thứ rẻ hơn chạy.
Đó cũng là giới hạn thành thật của nó. Một vòng lặp viết ra giấy không thể tặng cho model yếu thứ phán đoán mà nó không có. Cái nó làm được là ngăn model đó hỏng theo đúng mười kiểu mà lẽ ra nó sẽ hỏng — một tuyên bố nhỏ hơn, và vững hơn nhiều.
Liên quan
- Buổi 4 — Quản trị AI Engineering — vì sao một dấu tích xanh không phải là bằng chứng, qua một ca hỏng có thật.
- Buổi 5 — Quy trình làm việc AI-Driven — quality gate là bằng chứng đủ tin cậy, và ranh giới tự chủ của AI dừng ở đâu.
- Claude Fable 5 vs Claude Opus 5(tiếng Anh) — cùng hai hạng model đó, nhưng đo trên một task dựng sản phẩm thay vì một prompt.