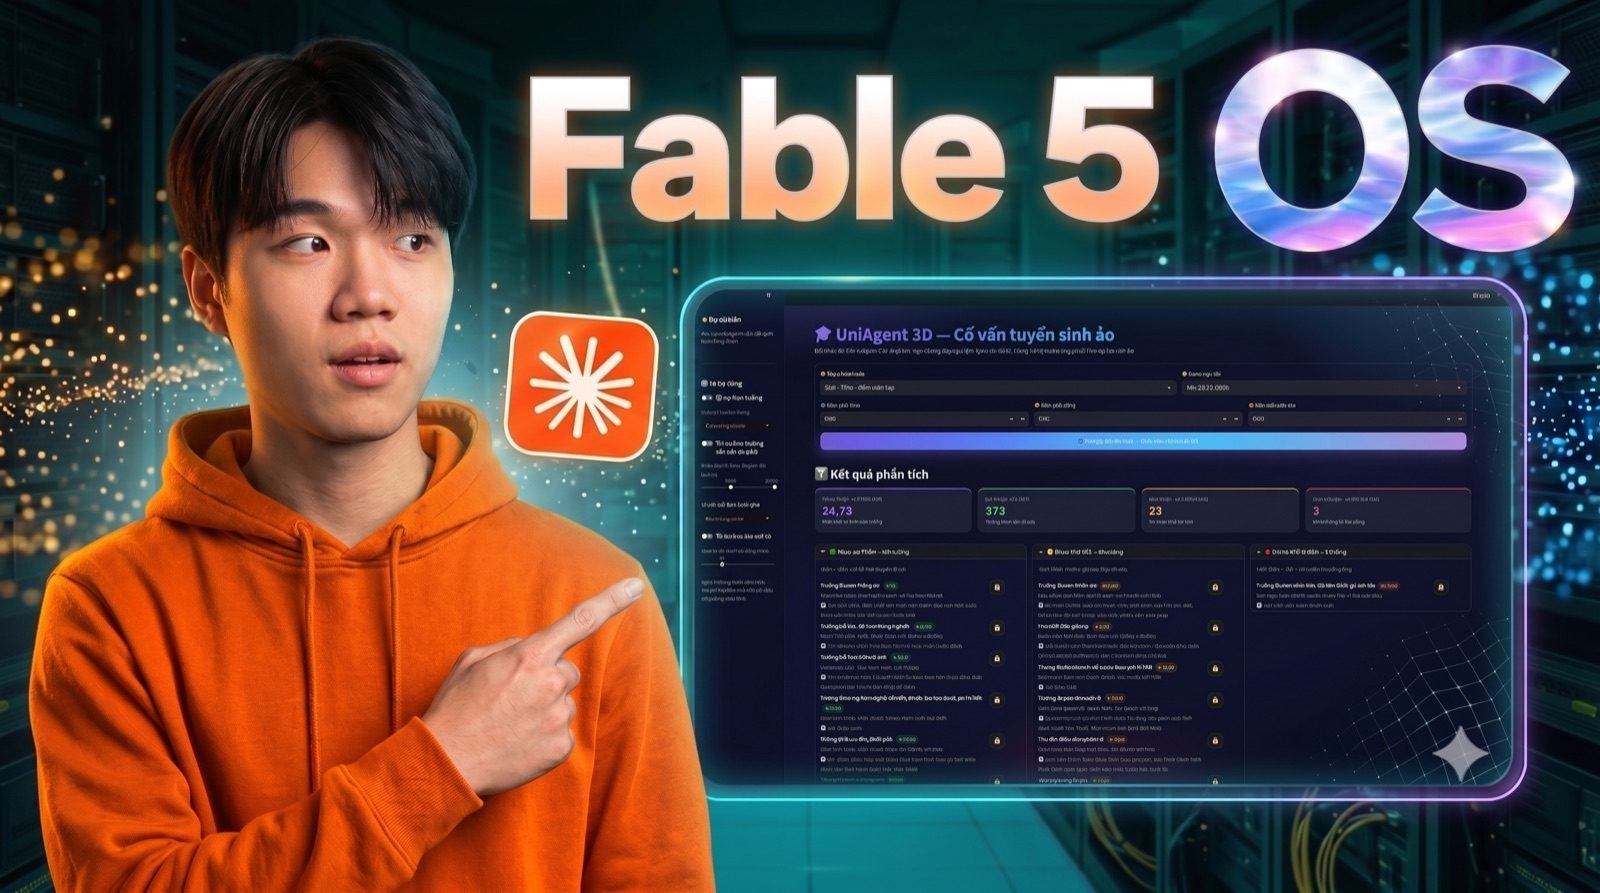
Claude Fable 5 trở lại: một demo có thể sai thật
Phần lớn demo model là thứ không thể phản bác. Dựng một landing page, viết một bộ slide, tóm tắt một báo cáo — kết quả trông ấn tượng, và chẳng ai chỉ được vào dòng nào để nói chỗ này sai sự thật. Nghĩa là demo chỉ chứng minh model tạo ra được thứ nhìn có vẻ hợp lý, chứ không chứng minh thêm được gì.
Demo này thì khác, và đó là lý do duy nhất khiến nó đáng viết lại.
Bài toán: lấy điểm chuẩn đại học 5 năm, lấy điểm thi của một thí sinh, rồi nói cho bạn ấy biết những ngành nào là khả thi. Mọi con số trong kết quả đều truy được về một dòng cụ thể trong một file cụ thể. Nếu model bịa ra một mức điểm chuẩn, bạn mở file ra là bắt được.
Về bài viết này
Viết từ video trên kênh. Những quan sát dưới đây — kể cả con bug mà chính demo để lộ — là những gì diễn ra trên màn hình. Chỗ nào là thông tin từ tài liệu của hãng chứ không phải từ lần chạy, mình ghi rõ.
Vì sao bài toán này là phép thử tốt
Tuyển sinh đại học ở Việt Nam chạy trên điểm chuẩn công bố theo từng ngành, từng năm. Thí sinh thi xong, có ba điểm môn cộng điểm ưu tiên khu vực, rồi phải tự đoán ngành nào vừa tầm.
Điều đó khiến nó thành một phép thử hiếm hoi mà trung thực với một agent:
- Có đáp án đúng. Điểm chuẩn năm 2023 của một ngành là một sự thật nằm trong file.
- Phép tính kiểm được. Ba môn cộng điểm ưu tiên, kèm quy tắc làm tròn — và làm tròn thì quan trọng thật.
- Sai thì trả giá thật. Một thí sinh tin vào mức điểm chuẩn bịa ra sẽ đưa ra một quyết định thật, một cách tồi.
Bài được dựng trong Claude Code với model Fable 5, chạy ở chế độ plan, trên một thư mục chứa dữ liệu điểm dạng markdown và một file riêng ghi quy chế cộng điểm ưu tiên khu vực 2026.
Đây là bản viết của video, nơi toàn bộ lần chạy diễn ra ngay trên màn hình — phần lên kế hoạch, mười lăm phút dựng, bước tự test, và cả con bug bộ lọc.
Muốn xem thẳng trên YouTube?
Xem trên YouTube — hoặc đăng ký kênh để đón video tiếp theo.
Bước đáng học nhất
Bước một tới bước bốn thì demo agent nào cũng làm: đọc đầu vào, lên kế hoạch, toả ra các sub-agent, xếp kết quả thành an toàn, vừa sức, thử thách.
Bước năm mới là bước có giá trị. Sau khi ra kết quả, agent mở lại chính các file nguồn và đối chiếu từng con số nó đã dùng. Không phải chạy test — mà là đối chiếu ngược lại với đúng cái bằng chứng đã dựng nên câu trả lời.
Đó là ranh giới giữa một agent nghe có vẻ đúng và một agent mà kết quả kiểm toán được. Cùng lập luận với buổi quản trị AI Engineering: một kết quả chỉ đáng giá bằng đúng bằng chứng của nó, mà bằng chứng không bao giờ được đọc lại thì không phải là bằng chứng.
Lần chạy đó thực sự diễn ra thế nào
Nó đọc trước khi lập kế hoạch. Được đưa thư mục, nó đi một vòng thư mục dữ liệu để hiểu cấu trúc trước, rồi mới sinh ra kế hoạch.
Nó bắt được lỗi trong chính dữ liệu đầu vào. File năm 2023 không phải bảng — nó bị để dạng text thuần trong khi các năm khác đều có cấu trúc. Model chỉ ra chỗ không đồng nhất đó và kiểm lại định dạng, thay vì cứ thế parse sai rồi đi tiếp. Đây mới là khoảnh khắc đáng nể nhất của cả demo, và không ai yêu cầu nó làm vậy.
Chế độ plan cho ra thứ duyệt được — cấu trúc dữ liệu, định dạng, cách xử lý tên trường, phần logic lõi, danh sách file cần tạo, các bước triển khai — trước khi viết một dòng code nào.
Nó tự test, không cần bảo. Dựng xong, nó tự mở trang web lên và bấm thử, kiểm các nút và phần logic. Trong prompt không hề nhắc tới testing.
Rồi một lượt thứ hai. Prompt tiếp theo thêm phần nhập theo tổ hợp môn (chọn A1, nhập riêng toán, lý, tiếng Anh). Thêm khoảng 15 phút nữa.
Và nó vẫn ra một con bug
Bộ lọc theo thành phố sai. Lọc Hà Nội thì ra Bình Dương.
Điều này đáng nói thẳng, vì chính video cũng nói thẳng. Một agent biết đối chiếu số liệu với file nguồn không vì thế mà đúng ở mọi chỗ còn lại. Bước kiểm chứng phủ phần con số — phần có đáp án đúng — và không nói gì về logic bộ lọc, vốn chẳng có đáp án nào để đối chiếu.
Đó đúng là dạng lỗi cần lường trước: kiểm chứng chỉ phủ đúng thứ bạn chỉ cho nó kiểm. Một dấu tích xanh trên điểm chuẩn không phải là lời khẳng định về giao diện.
Chi phí
| Lượt dựng đầu | ~15 phút |
| Lượt thứ hai (thêm tổ hợp môn) | ~15 phút |
| Token cho cả phiên | ~200.000 |
Nhận định của chính tác giả: nó sinh code chậm hơn thấy rõ so với các sản phẩm khác, và đó có vẻ là cái giá phải trả — nó lên kế hoạch, đối chiếu, đọc lại, thay vì phun code ra ngay. Mức tiêu thụ token cao. Với giá công bố của Fable 5 — 10 USD/triệu token đầu vào, 50 USD/triệu token đầu ra — một phiên 200k token là tiền thật, nên biết trước khi giao cho nó việc chạy dài.
Về cách gọi "sự trở lại"
Video mở đầu bằng chuyện model từng bị giữ lại vì lo ngại an ninh và nay đã dùng được, kèm phần lướt qua bảng benchmark do hãng công bố.
Hai lưu ý. Cả cách đặt vấn đề lẫn các con số đó đến từ tài liệu của chính hãng, không phải từ lần chạy này — một bảng benchmark do công ty làm ra model tự công bố thì vẫn là tiếp thị, cho tới khi có bên độc lập tái lập được. Và nhận định của chính tác giả còn dè dặt hơn phần mở đầu: lần trở lại này yếu hơn lần đầu, dù vẫn rất mạnh so với mặt bằng hiện có.
Mình thà chỉ vào lần chạy hơn là chỉ vào cái bảng. Lần chạy cho thấy một model biết đọc trước khi lập kế hoạch, bắt được lỗi định dạng chẳng ai chỉ ra, tự test mà không cần bảo — và vẫn giao ra một bộ lọc hỏng. Bức tranh đó nói về model thật hơn bất kỳ hàng phần trăm nào.
Điều mình rút ra
Muốn học được gì thì hãy cho bài toán một đáp án đúng. Demo này có ích chính vì kết quả của nó kiểm được. Nếu bài đánh giá của bạn không thể cho ra một câu sai phát hiện được, thì bạn đang đo độ trôi chảy.
Hãy yêu cầu bước đối chiếu một cách tường minh. Bước kiểm chứng ở đây là do thiết kế mà có, và đó là lý do duy nhất khiến "không hallucination" là một khẳng định chứ không phải một hy vọng.
Giới hạn niềm tin đúng bằng phạm vi đã kiểm. Số thì đã đối chiếu với file, bộ lọc thì chưa kiểm gì cả — và hỏng đúng ở bộ lọc.
Liên quan
- Fable Mode: Bắt model mạnh nhất viết sổ tay vận hành cho model thay thế nó — cùng model đó, nhưng dùng để viết ra luật vận hành thay vì viết code.
- Bộ não thứ hai tự bảo trì: Claude Fable 5 + Obsidian — cũng là chuyện xuất xứ: không nguồn thì không viết.
- Buổi 4 — Quản trị AI Engineering — vì sao một dấu tích xanh chỉ đáng giá bằng bằng chứng của nó.